

Faire évoluer DevLog sans casser ce qui fonctionne
RAG, MCP et découplage architectural autour d'une mémoire technique pour les agents de développement.
Dans mon précédent article, j'explorais une question qui commence à prendre une place importante dans le développement de DevLog :
jusqu'où une mémoire technique structurée peut-elle aider un workflow d'ingénierie à mieux comprendre les projets qu'il fait évoluer ?
Les premiers essais ont montré quelque chose d'intéressant.
DevLog est déjà capable de préparer une première carte du contexte d'un projet : structure du repository, historique Git, décisions d'architecture, connaissances validées ou encore fichiers potentiellement pertinents.
Mais cette carte reste imparfaite.
Certaines informations importantes ne sont pas encore connues, certaines sont mal classées et certaines catégories de preuves peuvent prendre trop de place.
J'avais résumé ces problèmes en trois mots :
Depuis, la réflexion a continué.
Deux technologies sont progressivement apparues comme intéressantes pour la suite du projet :
Mais leur introduction pose une question architecturale plus importante :
comment ajouter ces capacités sans transformer DevLog en un système fortement couplé où chaque nouvelle évolution oblige à reconstruire ce qui existe déjà ?
Le RAG n'est pas la prochaine feature
Lorsqu'un projet commence à accumuler beaucoup de connaissances, l'idée d'ajouter un système RAG arrive assez naturellement.
DevLog possède progressivement :
Une recherche uniquement structurée finira probablement par montrer ses limites.
Une recherche sémantique pourrait permettre de retrouver des informations conceptuellement proches même lorsqu'elles n'utilisent pas exactement les mêmes termes.
Mais ajouter immédiatement :
serait probablement une erreur.
Le problème actuel de DevLog n'est pas simplement de rechercher dans davantage de données.
Il faut d'abord améliorer ce que DevLog connaît réellement du projet.
Le premier travail reste donc l'enrichissement et la projection.
Ces projections doivent progressivement représenter des informations utiles comme :
Une fois cette base suffisamment riche, un Retrieval Layer pourra être introduit au-dessus.
Le RAG devient alors une technique de récupération supplémentaire.
Il ne devient pas la mémoire du projet.
La base vectorielle ne doit pas devenir la source de vérité
Cette distinction me semble particulièrement importante.
Une future base vectorielle devra rester une projection technique reconstruisible.
et jamais :
Cela permet de modifier plus tard :
sans modifier la connaissance métier de DevLog.
Le Retrieval Layer peut évoluer.
La mémoire du projet reste indépendante.
Un autre problème est apparu pendant le développement
Pendant cette réflexion autour du RAG, un problème beaucoup plus concret est apparu dans notre workflow.
Une partie du travail était orchestrée par Kiko.
Lorsque Kiko devenait temporairement indisponible --- par exemple à cause d'une limite de provider ou de tokens --- il fallait continuer directement avec un autre agent comme OpenCode.
Techniquement, OpenCode avait accès au repository.
Mais une partie importante du contexte devait être reconstruite manuellement.
Il fallait alors expliquer à nouveau :
Le problème n'était finalement pas OpenCode.
Le problème était que le contexte nécessaire pour poursuivre le travail dépendait encore trop du consommateur qui l'avait construit.
Cela nous a conduit à formuler un nouveau principe :
Engineering context must belong to the project, not to the agent currently consuming it.
MCP comme frontière
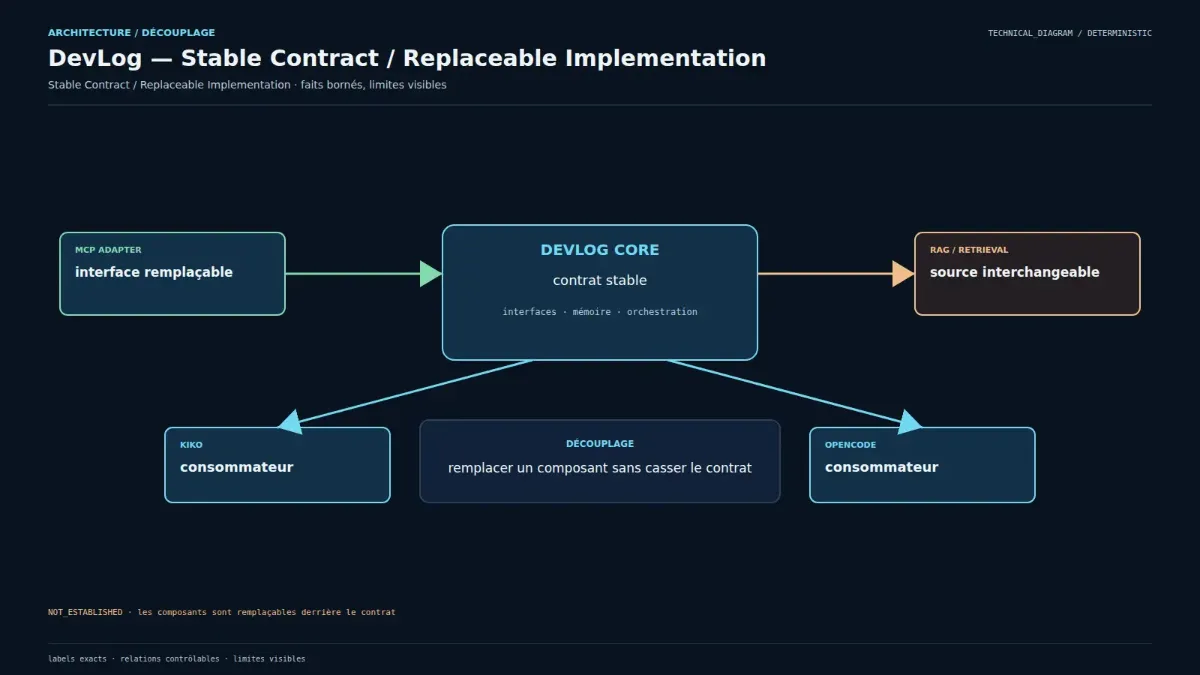
C'est ici que MCP devient intéressant.
L'idée n'est pas de construire un serveur MCP simplement parce que le protocole est populaire.
L'objectif est de créer une frontière standardisée entre DevLog et les outils qui souhaitent utiliser sa mémoire technique.
Kiko devient alors un consommateur parmi d'autres.
OpenCode également.
Et demain cela pourrait être :
DevLog ne doit pas savoir lequel utilise son contexte.
MCP ne doit pas devenir DevLog
Là encore, le découplage est essentiel.
Le serveur MCP ne doit contenir ni la logique métier de DevLog ni sa propre représentation de la connaissance.
Son rôle doit rester celui d'un adapter.
et surtout pas :
ou :
Si MCP disparaissait demain, DevLog devrait continuer à fonctionner.
Si MCP était remplacé par un autre protocole, la logique métier ne devrait pas être réécrite.
Commencer volontairement petit
Nous avons donc décidé de ne pas commencer directement par :
get_engineering_context()
connecté à toutes les connaissances DevLog.
Le premier prototype est volontairement beaucoup plus simple.
La première Resource retourne simplement :
{
  "name": "devlog-mcp",
  "version": "0.1.0",
  "status": "ready"
}
Avec MCP Inspector, nous avons pu vérifier toute la chaîne :
MCP Client
    ↓
resources/list
    ↓
devlog://server/info
    ↓
resources/read
    ↓
DevLog MCP Server
Ce n'est évidemment pas encore une fonctionnalité utile.
Mais c'est précisément l'objectif.
Avant de connecter DevLog, nous voulons comprendre le protocole et valider chaque frontière indépendamment.
Faire évoluer l'intérieur sans modifier l'extérieur
C'est probablement la partie de cette expérimentation qui m'intéresse le plus.
Aujourd'hui, une future capacité pourrait fonctionner ainsi :
Plus tard :
Du point de vue de l'agent :
n'a pas nécessairement changé.
L'intérieur de DevLog, lui, a considérablement évolué.
C'est exactement ce que nous recherchons avec le découplage.
RAG et MCP ne résolvent pas le même problème
Les deux technologies peuvent facilement être mélangées lorsqu'on parle d'agents et de contexte.
Je préfère les considérer comme deux responsabilités différentes.
Et DevLog reste entre les deux.
Cette séparation permet également d'introduire les technologies progressivement.
Nous pouvons travailler sur MCP aujourd'hui sans disposer du RAG.
Nous pouvons améliorer les projections sans MCP.
Nous pourrons expérimenter plusieurs stratégies de retrieval sans modifier les consommateurs.
Le découplage comme moyen d'expérimenter
Au début du projet, découper les responsabilités peut parfois sembler produire davantage de code.
Il faut définir des contrats.
Créer des adapters.
Éviter les accès directs.
Résister à la tentation de placer une logique là où elle est simplement pratique à court terme.
Mais cette expérimentation commence à montrer l'autre côté de cette approche.
Parce que DevLog distingue progressivement :
nous pouvons faire évoluer chacune de ces responsabilités indépendamment.
Le futur RAG ne nécessite pas de reconstruire DevLog.
MCP ne nécessite pas de déplacer la connaissance dans un nouveau service.
Un nouvel agent ne nécessite pas une nouvelle représentation du projet.
Et un changement de provider ne devrait progressivement plus signifier une perte du contexte d'ingénierie.
Une architecture qui doit rester remplaçable
Je commence à utiliser un critère assez simple lorsque nous introduisons une nouvelle technologie dans DevLog :
Que se passe-t-il si nous décidons de la remplacer dans six mois ?
Si remplacer la technologie implique de réécrire le domaine, le découplage est probablement insuffisant.
Pour le RAG :
Pour MCP :
Pour les agents :
Ce n'est évidemment jamais totalement gratuit.
Mais l'objectif est que les décisions techniques périphériques restent remplaçables sans remettre en cause la connaissance et les règles du projet.
Et maintenant ?
Le travail MCP vient seulement de commencer.
La première Resource fonctionne et le protocole a été validé avec un vrai client.
Les prochaines étapes seront volontairement progressives :
En parallèle, DevLog continuera à améliorer son enrichissement et ses projections.
Le Retrieval Layer viendra ensuite, lorsque ces informations seront suffisamment riches pour justifier une recherche hybride.
Puis MCP pourra exposer progressivement cette capacité aux différents consommateurs.
La trajectoire commence donc à ressembler à ceci :
Je ne sais pas encore jusqu'où cette architecture évoluera.
Mais cette phase du projet renforce une idée qui devient progressivement centrale dans DevLog :
la valeur ne vient peut-être pas seulement de la quantité de contexte qu'un système peut accumuler, mais de sa capacité à structurer cette connaissance de manière suffisamment indépendante pour qu'elle puisse évoluer, être recherchée et être consommée sans dépendre d'un modèle, d'un agent ou d'une technologie particulière.