
Ce que mesure vraiment DevLog AI : retour sur un benchmark encore imparfait
Format : Deep Dive · expérimentation · évaluation de contexte
Résumé
J’ai voulu mesurer une question simple : est-ce qu’un contexte DevLog structuré aide un modèle à répondre à des questions d’ingénierie à partir d’un repository ? Les notebooks d’évaluation donnent une réponse plus intéressante qu’un oui ou un non. Dans cette collection, le contexte structuré n’améliore pas la justesse de la conclusion avec le modèle Luna, mais il réduit les extrapolations et rend le raisonnement davantage soutenu par les preuves. En parallèle, le protocole révèle des défauts de contrat et de grounding qui empêchent de transformer ces observations en mesure produit définitive.
Ce deepdive s’appuie sur les collections figées et les résultats rendus dans les notebooks du repository. Il ne prétend pas décrire le code le plus récent de DevLog AI.
La question et le protocole
Le protocole compare deux conditions :
-
DEVLOG: le modèle reçoit une projection structurée et figée du contexte d’ingénierie ; -
DIRECT: l’agent reconstruit le contexte en inspectant directement le repository avec des outils bornés.
La collection officielle V4 contient 18 observations : trois questions, deux conditions et trois répétitions par paire question-condition. Les échecs de fournisseur, les censures et les réponses non évaluables restent des observations ; ils ne sont pas convertis artificiellement en réponses incorrectes.
Cette précaution est importante. Une réponse peut être sémantiquement correcte tout en échouant le contrat structurel ou la validation de ses localisateurs. À l’inverse, une absence de réponse exploitable ne constitue pas automatiquement une erreur sémantique.
Ce que montre la collection officielle V4
Sur les 18 observations :
-
7 sont terminées (
COMPLETED) ; -
6 s’arrêtent sur une défaillance du fournisseur (
PROVIDER_FAILURE) ; -
5 sont censurées par les limites d’exécution (
CENSORED) ; -
les 18 rejouabilités passent (
replayStatus = PASS).
La condition DEVLOG atteint 5 observations structurellement valides sur 9. Parmi ces observations éligibles, 4 sur 5 sont sémantiquement correctes. Mais aucune ne passe la validation de grounding dans cette collection.
La condition AGENT_DIRECT_OPEN ne produit aucune observation structurellement valide : 5 observations sont censurées et 4 rencontrent une défaillance du fournisseur. Il serait donc incorrect de conclure que DIRECT obtient une précision nulle. La mesure de précision n’est simplement pas disponible pour cette condition dans ce protocole.
Le résultat le plus utile n’est pas un classement
Les observations de ressources décrivent surtout deux trajectoires différentes :
-
DEVLOG: 7 appels fournisseur, aucune opération d’outil, 45 839 tokens d’entrée et 78 767 ms de latence totale ; -
AGENT_DIRECT_OPEN: 50 appels fournisseur, 92 tentatives d’outil, 58 opérations exécutées, 25 requêtes invalides, 246 567 tokens d’entrée et 110 732 ms de latence totale.
Ces valeurs ne constituent pas un score d’efficacité. Les conditions ne s’arrêtent pas au même stade et le coût monétaire n’est pas disponible. Elles montrent cependant que reconstruire le contexte à la volée ajoute une surface d’exécution importante, avec des erreurs d’outillage qui deviennent elles-mêmes une partie du résultat.
Ce que la comparaison Luna permet d’isoler
Le notebook comparatif distingue l’effet du contexte de l’effet du modèle. Avec Luna, les deux conditions atteignent 6 conclusions correctes sur 9. La différence apparaît dans la qualité du raisonnement :
-
Luna + DEVLOG produit un raisonnement entièrement soutenu dans 6 cas sur 9 et aucun overclaim ;
-
Luna + DIRECT produit un raisonnement soutenu dans 3 cas sur 9 et trois overclaims.
Dans cet échantillon, le contexte structuré ne change donc pas le nombre de conclusions correctes. Il change surtout le niveau de retenue : il aide le modèle à ne pas compléter les blancs avec des éléments plausibles mais non établis par les preuves.
Le même notebook montre aussi un effet de modèle. Avec le même contexte DEVLOG, GPT-4.1-mini atteint 9 conclusions correctes sur 9, contre 6 sur 9 pour Luna. Ce résultat est lié à ce jeu de questions, à ses trois répétitions et à des chemins de collecte différents. Il ne permet pas de classer globalement les modèles.
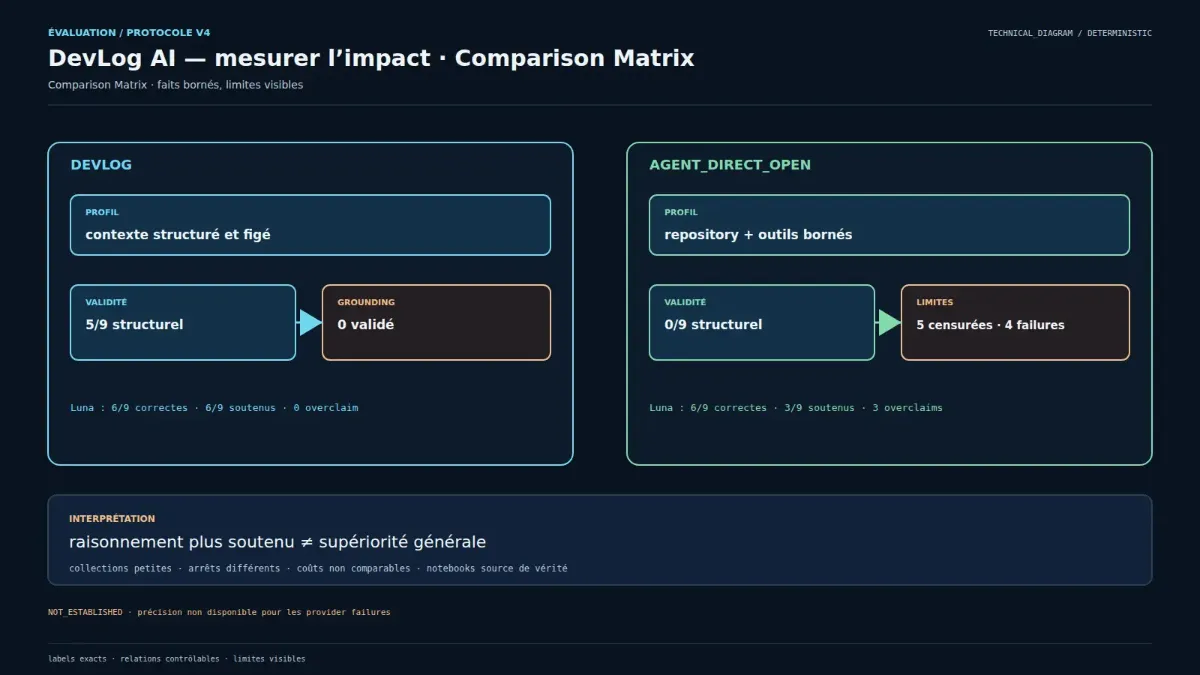
Figure 1 — Les conclusions finales peuvent être identiques alors que le raisonnement causal et son support par les preuves divergent.
Trois cas, trois enseignements
CASE-01 : une relation d’architecture sensible au modèle
L’oracle attend que la relation entre ADR-042 et Story-0039 soit établie. GPT-4.1-mini + DEVLOG la reconnaît dans les trois répétitions. Luna, avec DEVLOG comme avec DIRECT, répond NOT_ESTABLISHED dans les trois répétitions.
Le contexte n’a pas suffi à compenser cette différence de comportement du modèle.
CASE-03 : le risque d’élargir une preuve locale
La question porte sur l’impact autour de PaperSettlementService et des tests de règlement, dont PaperSettlementExitTest. Les trois traitements atteignent la bonne conclusion. DIRECT ajoute toutefois des composants et des tests plausibles mais non soutenus par l’oracle figé ; il est classé comme overclaiming.
Le contexte structuré ne rend pas automatiquement la réponse plus vraie, mais il fournit une frontière plus nette autour de ce qui est effectivement démontré.
CASE-04 : le contrôle négatif
Les preuves ne permettent pas d’établir que ADR-043 a causé la refactorisation Story-0042 autour de ExecutionConfiguration. Les trois traitements donnent la conclusion négative correcte et s’abstiennent de relier les éléments.
Ce cas est essentiel : savoir ne pas conclure fait partie de la qualité d’un système de mémoire technique.
Un signal également intéressant sur le coût
La collection V4 mesure aussi les ressources observées pendant les traitements. Les valeurs agrégées sont très différentes : DEVLOG totalise 45 839 tokens d’entrée et 78 767 ms de latence, tandis que AGENT_DIRECT_OPEN totalise 246 567 tokens d’entrée et 110 732 ms de latence, avec 92 tentatives d’outil et 25 requêtes invalides.
La comparaison Luna fournit une autre lecture descriptive : environ 9 101 tokens et 7,6 secondes pour GPT-4.1-mini + DEVLOG, 22 661 tokens et 26,5 secondes pour Luna + DEVLOG, et 176 443 tokens et 72,6 secondes pour Luna + DIRECT.
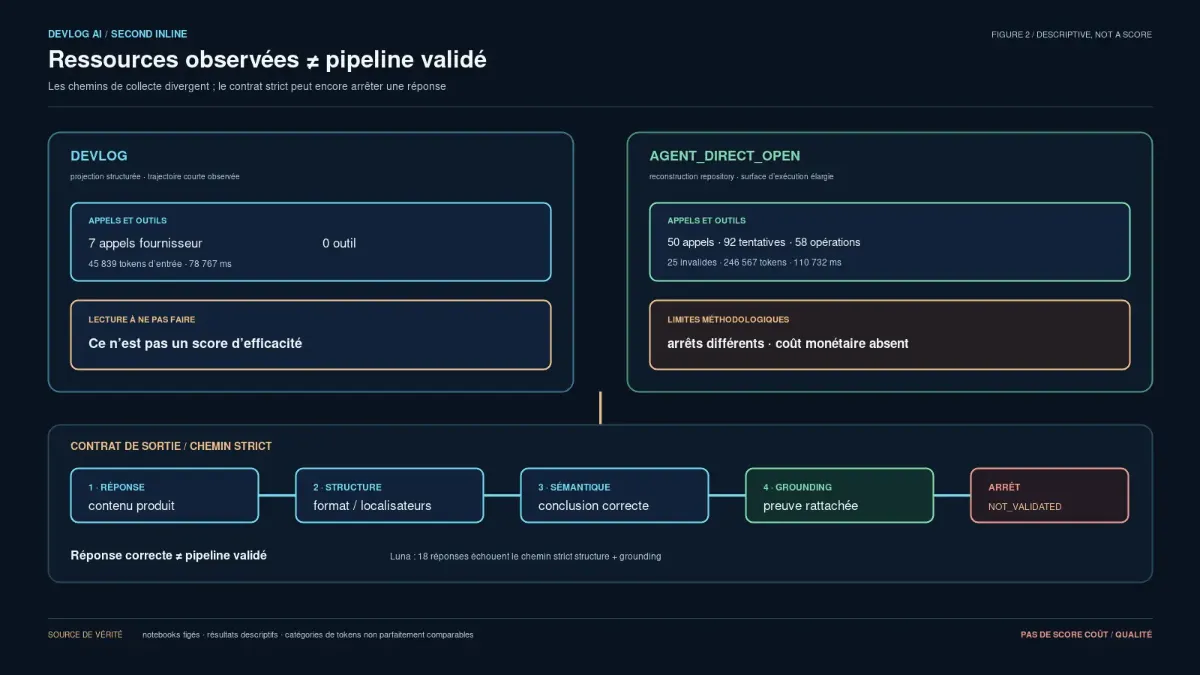
Figure 2 — Comparaison descriptive des ressources observées. Les chemins de collecte ne sont pas parfaitement homogènes : ce graphique ne constitue pas un score coût/qualité.
Ces chiffres ne permettent pas d’écrire que DevLog consomme systématiquement moins. Les conditions ne s’arrêtent pas au même stade, les catégories de tokens ne sont pas parfaitement comparables et le coût monétaire n’est pas disponible. Ils montrent seulement que, dans ces collections, fournir un contexte structuré a été associé à un workflow observé plus court que reconstruire le contexte depuis le repository.
Le problème du contrat de sortie
Les résultats sémantiques sont utiles pour comprendre les comportements, mais ils ne suffisent pas à valider le pipeline. Dans la comparaison Luna, les 18 réponses échouent le chemin strict de structure et de grounding. Dans la collection V3, DEVLOG atteint la validation structurelle sur 7 observations, mais aucune ne passe le grounding ; DIRECT n’atteint aucune validation structurelle.
Le benchmark mesure donc aussi la difficulté de faire coïncider :
-
une réponse compréhensible par un humain ;
-
un contrat machine strict ;
-
des localisateurs qui pointent vers des preuves vérifiables ;
-
une interprétation sémantique fidèle à l’oracle.
Tant que ces niveaux restent confondus, une amélioration de la prose peut être masquée par un échec de format, et une réponse correcte peut rester inutilisable pour le pipeline.
Ce que je peux affirmer
Les notebooks permettent d’affirmer que :
-
les collections sont petites et descriptives : trois questions et trois répétitions par traitement ;
-
le contexte DEVLOG réduit les overclaims dans la comparaison Luna observée ;
-
la justesse des conclusions varie avec le modèle dans ce jeu figé ;
-
la collecte DIRECT consomme davantage d’opérations et de contexte dans la collection V4 ;
-
le grounding et le contrat de sortie restent des limites majeures.
Ce que je ne peux pas affirmer
Les données ne permettent pas de conclure que :
-
DevLog améliore universellement la qualité des réponses ;
-
DIRECT a une précision de 0 % ;
-
Luna est globalement moins bon que GPT-4.1-mini ;
-
le coût par réponse est mesuré de manière comparable entre toutes les conditions ;
-
le code courant du repository produit exactement les mêmes résultats que les collections figées.
Ce que cette expérimentation change dans le projet
La priorité n’est pas d’ajouter une nouvelle couche d’IA. Elle est de préserver la frontière entre preuve, interprétation et contrat de sortie :
-
stabiliser la représentation des localisateurs et des extraits ;
-
rendre les échecs de grounding directement inspectables ;
-
conserver la retenue observée avec le contexte structuré ;
-
continuer à séparer l’effet du modèle de l’effet du contexte ;
-
répéter le benchmark avec un protocole dont les conditions atteignent toutes les mêmes étapes d’évaluation.
Sources et reproductibilité
Les chiffres de cet article viennent des notebooks suivants, versionnés dans le repository Hopeful117/devlog-ai :
Les notebooks constituent ici la source de vérité éditoriale. Les chiffres peuvent diverger de l’état actuel du code ou d’une future nouvelle collection ; cette divergence devra être explicitement signalée dans toute mise à jour de l’article.
Article préparé comme Deep Dive. Les résultats sont descriptifs, les limites font partie du résultat et aucune conclusion de supériorité générale n’est revendiquée.